Антиплагиат 2.0 в вузах: как новая система проверяет текст на ИИ и нейросети
В практике образовательной платформы СтудИзба мы ежедневно наблюдаем, как стремительно трансформируются требования к подготовке курсовых и дипломных проектов. Еще недавно главным критерием оригинальности выступало классическое отсутствие прямых заимствований из чужих публикаций. Однако массовое распространение генеративных нейросетей перевернуло университетский контроль. По многолетнему опыту СтудИзбы и наблюдениям за защитами выпускных квалификационных работ в ведущих российских университетах, традиционный формат контроля исчерпал себя: сгенерированный с нуля материал формально показывает высокую оригинальность в старых базах, но не отражает реальных компетенций автора. Ответом на этот вызов стала разработка новой платформы — Антиплагиат 2-0 в вузах как новая система проверяет текст на ИИ и нейросети уже в ходе текущего учебного года.
Новая система меняет сам вектор контроля: вместо запоздалого сканирования уже готового файла DOCX или PDF университеты переходят к комплексному анализу процесса подготовки исследования. В этой статье подробно разберем, как устроена архитектура обновленного сервиса, какие математические метрики выявляют машинную генерацию, почему страдают добросовестные авторы и как законно защитить свои исследовательские результаты.
Что такое Антиплагиат 2.0 и почему вузы меняют правила проверки студенческих работ
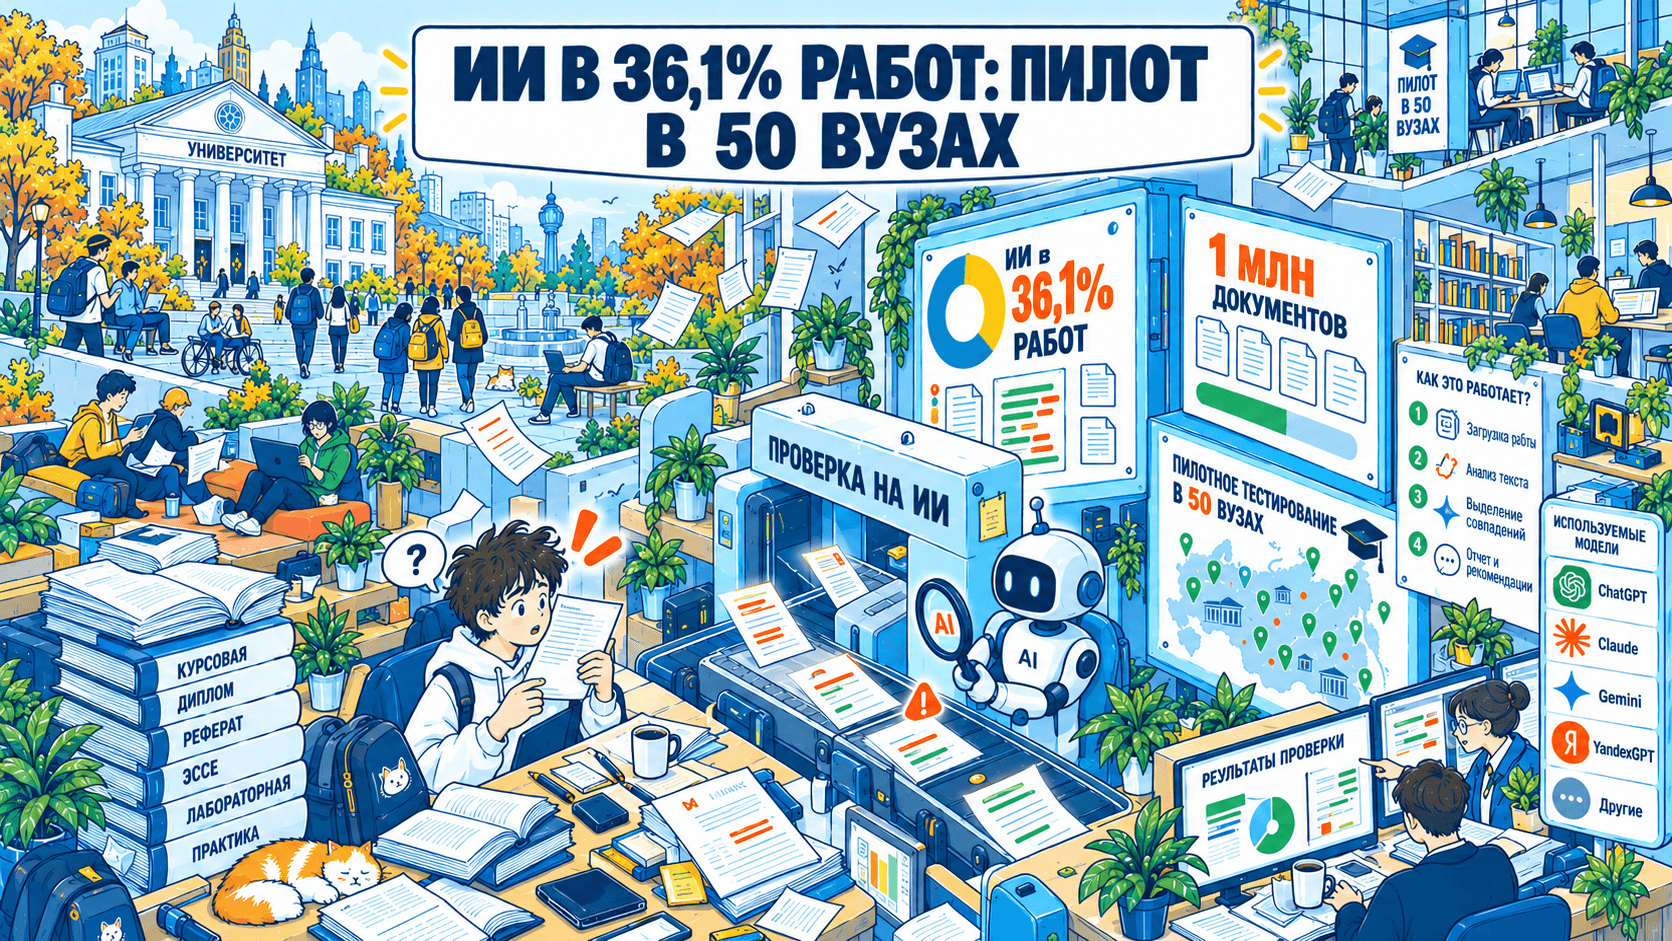
Масштабы использования генеративных технологий в высшей школе достигли критической отметки. Согласно исследованию компании «Антиплагиат», во втором квартале 2026 года признаки применения генераторов были зафиксированы в 36,1% студенческих работ (для сравнения, во втором квартале 2025 года этот показатель составлял 22%). Всего за три месяца весеннего семестра 2026 года из 2,73 миллиона проверенных документов маркеры машинного авторства были обнаружены почти в 984 тысячах работ. Опросы олимпиады «Я — профессионал» показывают еще более выразительную картину: до 85% обучающихся регулярно задействуют нейросетевые инструменты для поиска источников, рерайтинга или структурирования глав.
Классический антиплагиат создавался для сопоставления текста с накопленной базой источников (коллекции РГБ, кольцо вузов, eLIBRARY). Синтезированные фразы в таких базах отсутствуют, из-за чего прежние поисковые механизмы оказываются бессильны. В ответ на это компания разработала концепцию «Антиплагиат 2.0», впервые публично представленную на ПМЭФ-26.
Первый пилотный проект прошел с 25 февраля по 3 июля 2026 года с участием 28 университетов из более чем 20 регионов России и Беларуси. В тестировании участвовали свыше 2400 обучающихся и более 750 преподавателей, выполнивших свыше 10 000 проверок. Осенью 2026 года стартовал расширенный этап внедрения с веб-редактором уже в 50 вузах страны. Главная задача новой архитектуры — не тотальный запрет технологий, а создание прозрачной среды, где подтверждается личный вклад автора на каждом этапе исследования.
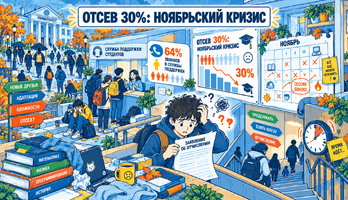
Масштабы пилотного внедрения, активность студентов и статистика точности детекторов, 2026 год
Более 20 регионов РФ и Беларуси, свыше 2 400 студентов и 750 преподавателей
Зафиксировано во II кв. 2026 г. (~984 тыс. из 2,73 млн работ против 22% годом ранее)
Популярность нейросетей у студентов в пилоте («Алиса AI» — 25%, GigaChat — 13%)
Во введениях (49%) и заключениях (56%) из-за стандартных формулировок ГОСТ (ReText.AI)
В среднем 25 содержательных комментариев и правок наставника на одну работу
Внедрение облачного веб-редактора с поведенческим трекингом процесса написания
Как алгоритм анализирует текст и распознает сгенерированный текст нейросетей
Детектор машинной генерации опирается не на поиск текстуальных совпадений, а на глубокий статистический и семантический анализ языковых закономерностей. Современные трансформерные классификаторы оценивают распределение вероятностей появления каждого последующего слова. Человеческая речь естественна, эмоциональна и неравномерна, тогда как сгенерированный текст подчиняется законам математической оптимизации языковых моделей.
Модуль детекции в системе «Антиплагиат.ВУЗ» обучен распознавать паттерны всех ведущих мировых и отечественных платформ: семейства ChatGPT от OpenAI (включая GPT-4o), Claude от Anthropic, DeepSeek, а также отечественных разработок YandexGPT и GigaChat. Анализ проводится на связных фрагментах объемом от 500–1000 знаков, поскольку на коротких фразах статистические закономерности размываются.
Языковые модели и маркеры ИИ-генерации: перплексия и шаблоны ChatGPT
В математическую основу детектора заложены две взаимодополняющие метрики:
- Перплексия (Perplexity, PPL): показатель информационной неожиданности или энтропии последовательности слов. Большие языковые модели обучаются предугадывать наиболее вероятное продолжение фразы. При формировании ответа генератор отдает предпочтение токенам с высокой вероятностью. Из-за этого перплексия машинного материала оказывается противоестественно низкой и монотонной. Спонтанный авторский слог, напротив, изобилует неожиданными лексическими переходами и метафорами.
- Берстность (Burstiness): мера вариативности синтаксической длины и структуры фраз во всем документе. Человек пишет всплесками: за длинным распространенным предложением с деепричастными оборотами часто следует короткий лаконичный тезис. Модели семейства ChatGPT стремятся к балансу, выдавая синтаксически выровненные, однотипные по длине конструкции.
К этому добавляется анализ рангового распределения токенов (Log-Rank): до 90% слов синтетического абзаца попадают в так называемую зеленую зону наивысшей статистической вероятности. Дополнительно алгоритм детектирует речевые артефакты — клишированные вводные обороты («следует подчеркнуть», «нельзя не отметить», «в современном быстро меняющемся мире»), стерильную безоценочность и галлюцинации в библиографических ссылках.
Цифровой след документа: как система фиксирует, которые студент вносил правки
Фундаментальное новшество платформы «Антиплагиат 2.0» заключается в модуле «Трекинг создания работы». Вместо загрузки разрозненных файлов студенты получают возможность писать текст непосредственно во встроенном облачном веб-редакторе. В этот момент формируется непрерывный поведенческий аудит:
- Динамика набора текста: система фиксирует скорость ввода символов (WPM/CPM). Живой набор человеком составляет в среднем 120–300 знаков в минуту и сопровождается естественными паузами, опечатками и нажатиями клавиши Backspace.
- События копирования и вставки: мгновенное появление фрагмента в 3000–8000 знаков за доли секунды однозначно классифицируется как внешний копипаст и отправляется на углубленную проверку.
- Хронология правок: преподаватель видит пошаговые изменения, выполненные автором на протяжении недель или месяцев работы над проектом.
- Журнал запросов: система позволяет прикреплять формулировки промптов, демонстрируя научному руководителю, что нейросеть применялась лишь как вспомогательный инструмент для систематизации мыслей, а не для подмены авторского труда.
В пилотном проекте для студентов научные руководители оставили в среднем по 25 содержательных комментариев на каждую работу, что подтвердило переход от карательного надзора к совместному наставничеству.
От ретроспективного поиска совпадений к поведенческому аудиту процесса создания
Ошибки детекторов: почему система подозревает оригинальный академический текст
Главный вызов современных детекторов — риск ложноположительных срабатываний (False Positive). Парадокс заключается в том, что академический стиль изложения по своей природе максимально близок к машинному выводу. Требования ГОСТ 7.32 и ГОСТ Р 7.0.11 обязывают авторов использовать строгие канцеляризмы, безличные конструкции («было установлено», «в ходе эксперимента выявлено») и стандартизированный терминологический аппарат.
По данным масштабного исследования компании ReText.AI на корпусе из 12 996 дипломных работ, детекторы чаще всего дают сбой во вводных и заключительных разделах: маркеры синтетической генерации обнаруживаются в 49% введений и 56% заключений. Причина проста — жесткие шаблоны описания объекта, предмета, актуальности и задач исследования программа ошибочно принимает за генерацию. Даже в архивных дипломах, защищенных до 2022 года (до появления публичных LLM), фоновый уровень ложного срабатывания достигает 9,9%.
Особенно часто под подозрение попадают научные главы по юриспруденции и экономике из-за прямого цитирования законодательных актов, а также научные статьи, переведенные с иностранных языков.
Отчет об использовании искусственного интеллекта и регламенты вузов
Важно помнить фундаментальное правило: процент в отчете проверки носит исключительно рекомендательный и ориентировочный характер. Ни одна автоматическая программа оценки дипломных проектов не наделена юридическим правом принимать решение о недопуске к защите или отчислении.
Позиция Министерства науки и высшего образования РФ, неоднократно озвученная главой ведомства Валерием Фальковым, однозначна: итоговую оценку самостоятельности дает преподаватель и Государственная экзаменационная комиссия в процессе очной защиты.
Ведущие университеты оперативно формируют локальные нормативные акты:
- НИУ ВШЭ: весной 2026 года приняла обновленный регламент, обязывающий выпускников декларировать работу с генеративными моделями через специальную анкету в LMS и приводить в тексте раздел с описанием роли модели.
- МГПУ: еще в августе 2023 года официально разрешил обращаться к нейросетям для поиска гипотез и структурирования черновиков при условии обязательной критической перепроверки фактов.
- УрФУ и Финансовый университет: установили пороги допустимого применения инструментов ИИ (до 30%) при условии открытой маркировки промптов, одновременно запретив преподавателям делегировать проверку работ алгоритмам.
Федеральный закон № 273-ФЗ «Об образовании в РФ» закрепляет автономию образовательных организаций, поэтому перед сдачей ВКР необходимо внимательно изучить справочник студента по академическим правам и регламентам аттестации и правила использования ИИ своего факультета.
Как студенту защитить работу и законно применять ИИ в учебных целях
Чтобы минимизировать риски и уверенно пройти нормоконтроль, эксперты рекомендуют придерживаться стратегии доказуемого авторства:
- Фиксируйте историю изменений: набирайте курсовую или диплом в редакторах с включенной версионностью (Яндекс Документы, Google Docs, облачные сервисы Word). Детализированный лог с датами за несколько месяцев — железобетонное доказательство вашей самостоятельности.
- Изучайте защищенные работы: чтобы понимать логику чистого текста без аномалий, анализируйте реальные образцы ВКР и дипломов по вашей специальности.
- Ведите журнал промптов: сохраняйте диалоги с чат-ботами. Открытая демонстрация того, как вы уточняли формулировки задач или искали синонимы, снимает подозрения в академическом подлоге.
- Глубоко перерабатывайте фактуру: не копируйте синтезированные абзацы целиком. Проверяйте каждую сноску, сверяйте статистику по авторитетным базам eLIBRARY и КиберЛенинка.
- Грамотно реагируйте на претензии: если антиплагиат выделил страницы розовым маркером, требуйте развернутый отчет с постраничной детализацией. Аргументированно объясните научному руководителю, что система отреагировала на нормативные клише, цитаты из ГОСТов или нормативно-правовых актов.
Пошаговый алгоритм защиты курсовой и ВКР в эпоху поведенческого аудита и нейросетей
Набирайте текст в Яндекс Документах, Google Docs или облачном Word. Пошаговая история версий с датами и временем за 2–4 месяца — железобетонное подтверждение самостоятельного набора.
Опирайтесь на структуру реальных защищенных ВКР по вашей специальности. Это помогает выстроить живой научный язык без синтаксической стерильности и аномально низкой перплексии.
Сохраняйте диалоги с чат-ботами (скриншоты или текстовый лог). Открытое декларирование показывает руководителю, что ИИ использовался для поиска идей или синонимов, а не для подмены авторства.
Не копируйте машинные абзацы целиком. Сверяйте каждую ссылку и показатель через eLIBRARY и КиберЛенинку: алгоритмы легко детектируют галлюцинации нейросетей в библиографических списках.
При подозрениях системы требуйте полный отчет с локализацией фрагментов. Докажите кафедре, что детектор среагировал на стандартные клише ГОСТов, цитаты законов или выводы введения.
Частые вопросы о проверке работ на искусственный интеллект (FAQ)
Видит ли стандартный Антиплагиат текст нейросети, если модуль проверки на ИИ отключен?
Базовый поисковый модуль сравнивает работу с существующими публикациями и открытыми источниками. Сгенерированные фрагменты отсутствуют в проиндексированных базах, поэтому без специализированного модуля детекции система покажет высокий процент оригинальности. Однако сегодня модуль детекции ИИ подключен в подавляющем большинстве российских вузов в пакете «Антиплагиат.ВУЗ».
Помогают ли синонимайзеры и замена букв на латиницу?
Любые попытки технических манипуляций (невидимые символы, замена раскладки клавиатуры, скрытые слои) мгновенно фиксируются модулем маскировок. Файл получает статус «Подозрительный документ», что автоматически влечет за собой служебную проверку и передачу дела на дисциплинарную комиссию.
Имеет ли право преподаватель снизить оценку только из-за высокой вероятности ИИ в отчете?
Нет, оценка выставляется за содержание исследования, владение материалом и ответы на вопросы в ходе защиты. Отчет детектора служит лишь поводом для более детального собеседования по проблемным разделам.
Распознает ли система модели с открытым исходным кодом (например, DeepSeek)?
Да. Детекторы анализируют не программную сигнатуру разработчика, а статистическую гладкость синтаксиса и распределение вероятностей лексики, характерное для всех современных авторегрессионных трансформеров.